OTE-001 / OBSERVED
Enterprise Process Reconstruction
532a63990523a89438a28fd0b68fb52db5cca98183be0b59a7fc1c340ec9c3ea
DYNAMICS LAB / ENGINE 02 / v0.1.0
Modeling Complex Business Operations Through Digital Twins.
Dalle registrazioni di ordini e pratiche ricostruisce i passaggi di un processo aziendale. Crea un gemello digitale, cioè un modello software del processo, e misura quanto ne riproduce i tempi e i percorsi. Permette poi di esplorare cambiamenti ipotetici.
BPI Challenge 2019 / Apri il report ↓Capire il processo prima di cambiarlo.
In praticaPuoi esplorare cosa succede nel modello se arrivano più pratiche o diminuiscono alcuni passaggi ripetuti. I risultati descrivono uno scenario ipotetico; i confronti con i dati reali mostrano anche dove il modello deve migliorare.
4080 € – 12.240 €
12 revisioni di processo/anno × 4–12 ore risparmiate per attività × 85 €/ora.
Scenario illustrativo da verificare in un pilota, al lordo dei costi di adozione.
Riferimenti4TU · BPI ChallengeCelonis · Purchase-to-PaySimPy
Comprendere il processo. Modellare il sistema. Verificare il cambiamento.
Operations Twin ricostruisce le attività e le relazioni presenti nei dati, calibra modelli del comportamento osservato e li confronta con pratiche di periodi successivi. Permette di esplorare cambiamenti ipotetici, rendendo esplicite assunzioni, incertezza e limiti.
HOW IT WORKS
IMPLEMENTED CAPABILITIES
Importazione XES/CSV/Parquet/JSON, ricostruzione delle tracce, varianti, grafo delle transizioni e analisi dei tempi. SimPy gestisce risorse, code FIFO ed eventi; Monte Carlo misura variabilità e sensibilità.
Streaming XES + columnar Parquet
Category-specific process discovery
Empirical and semi-Markov twins
SimPy FIFO resources / event scheduler
Chronological independent validation
Paired Monte Carlo / sensitivity
OTE-001 / DATI STORICI REALI
Il log pubblico BPI Challenge 2019 descrive un processo Purchase-to-Pay reale. Il file XES completo è verificato contro la fonte 4TU; le quattro categorie di matching restano distinte. Pratiche, documenti ed eventi non vengono confusi.
BPI Challenge 2019 / Boudewijn van Dongen / 4TU.ResearchData / version 1 / CC BY 4.0 / 11.973 varianti osservate
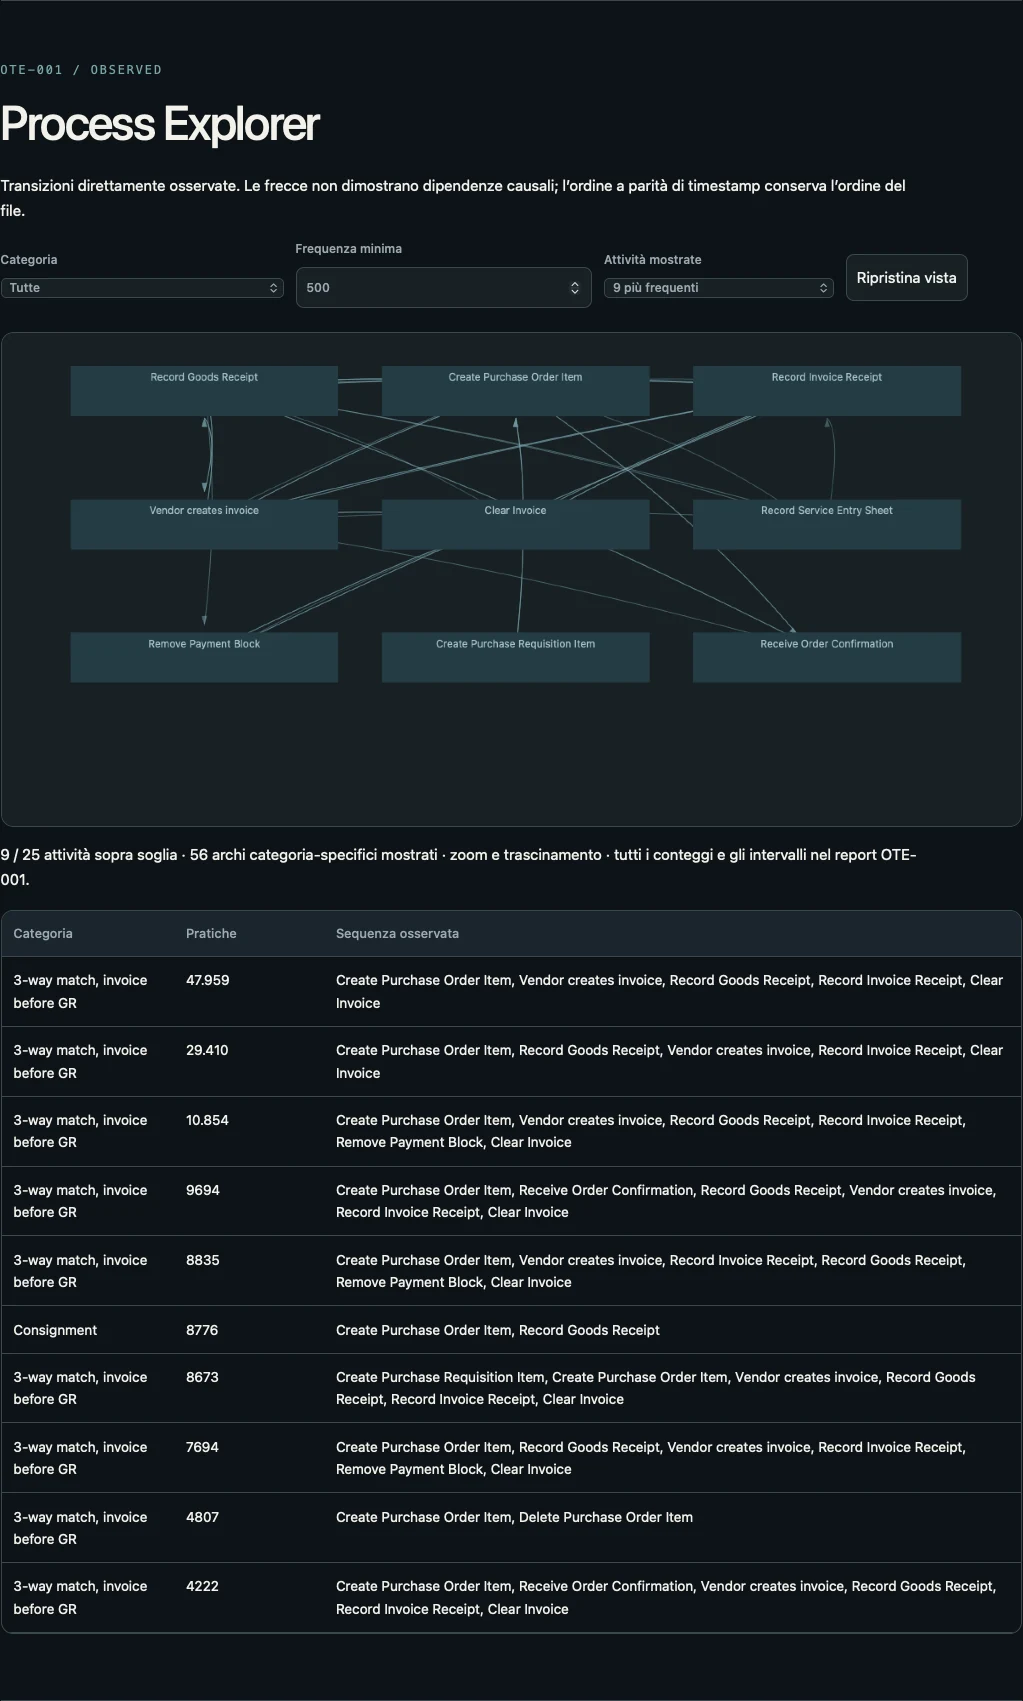
Timestamp fuori dal periodo dichiarato, identificativi mancanti e possibili duplicati sono conteggiati. Non vengono corretti o eliminati in silenzio. Le durate sono intervalli trascorsi fra osservazioni: non misurano direttamente lavoro o attesa.
45.455 / 1.595.923 events outside declared 2018
0% excluded from full discovery
132.748 exact-attribute duplicate candidates retained
OTE-001
Il registro BPI 2019 ha permesso di ricostruire 251.734 casi, quasi 1,6 milioni di eventi e 11.973 sequenze diverse. Le varianti mostrano che il processo d’acquisto osservato seguiva molti percorsi, utili per individuare dove approfondire.
Limiti della prova. Il tempo tra due eventi è un intervallo osservato. Il registro non consente di separare lavoro e attesa, e una ripetizione può dipendere da attività legittime.
OTE-002 / INDEPENDENT TEMPORAL TEST
Apri un modello per vedere il problema, il contributo nel progetto e un possibile impiego professionale.
Tre modelli, gli stessi dati e un test cronologico indipendente. Il modello viene scelto sul periodo di validazione, prima del test. Qui sono visibili gli errori di tutti i modelli, comprese le baseline.
23.886 calibration cases · 3000 validation cases · 1757 independent test cases / 654 documents
| Modello | Errore durata media | Errore mediana | Errore P90 | Errore throughput | Distanza varianti TV |
|---|---|---|---|---|---|
| pooled_bootstrap / validation-selected | 12,16% | 10,24% | 22,52% | 15,28% | 0,372 |
| category_bootstrap | 11,72% | 9,97% | 21,68% | 15,07% | 0,369 |
| semi_markov | 11,57% | 1,96% | 30,81% | 18,2% | 0,781 |
Il modello selezionato riproduce alcuni indicatori aggregati, ma la distribuzione dei percorsi non rientra ancora in tutte le soglie prefissate. Il benchmark documenta dove funziona e dove occorre migliorarlo; il gemello non è presentato come completamente validato.
Variant TV acceptance bound ≤0.30 / selected model: 0,372. Error of mean elapsed duration: 12,16%.
| Test category | N | Copertura intervallo durata nominale 90% |
|---|---|---|
| 2-way match | 1 | 100% / insufficient evidence |
| 3-way match, invoice after GR | 104 | 93,27% |
| 3-way match, invoice before GR | 1652 | 92,55% |
OTE-002
Il bootstrap aggregato, scelto sul campione di validazione, ha stimato i tempi medi del test con il 12,2% di errore relativo. La distanza tra le distribuzioni delle varianti è stata però 0,372, oltre la soglia di 0,30. Tutti e tre i modelli superavano quella soglia: il gemello riproduce meglio i tempi che i percorsi.
Limiti della prova. La validazione è parziale e retrospettiva, con arrivi osservati già noti al simulatore. Per la categoria a due vie c’era un solo caso di test.
OTE-003 / SCENARI IPOTETICI / NON VALIDATI
Sette scenari, con repliche Monte Carlo e confronti appaiati: crescita della domanda, capacità, servizio ipotizzato, transizioni Change/Cancel, interruzione temporanea e modifiche combinate. Gli effetti descrivono il modello, senza promettere risultati economici reali.
750 base cases · 50 Repliche per scenario · 7 scenarios · 9 sensitivity cells · assumed service share 0.05 · designed utilization 0.70
| Scenario | Durata media simulata | 95%CI / MC mean | Paired Δ vs base / days |
|---|---|---|---|
| base | 49,14 d | 48,92 – 49,36 | 0 |
| demand growth | 49,98 d | 49,77 – 50,2 | 0,841 |
| capacity reduction | 49,95 d | 49,67 – 50,23 | 0,806 |
| automation | 48,81 d | 48,59 – 49,03 | -0,336 |
| rework reduction | 49,09 d | 48,88 – 49,31 | -0,049 |
| disruption | 49,18 d | 48,97 – 49,4 | 0,041 |
| combined | 48,8 d | 48,62 – 48,98 | -0,347 |
OTE-003
Nelle 50 repliche per scenario, l’automazione ipotizzata riduceva il ciclo medio da 49,14 a 48,81 giorni simulati. Più domanda o meno capacità allungavano la coda. Il modello mostra la direzione degli effetti per le ipotesi scelte.
Limiti della prova. Capacità, tempi di servizio e interventi sono ipotetici. Le differenze non dimostrano risparmi o miglioramenti ottenibili in azienda.
COMPUTED EVENTS / INTERACTIVE REPLAY
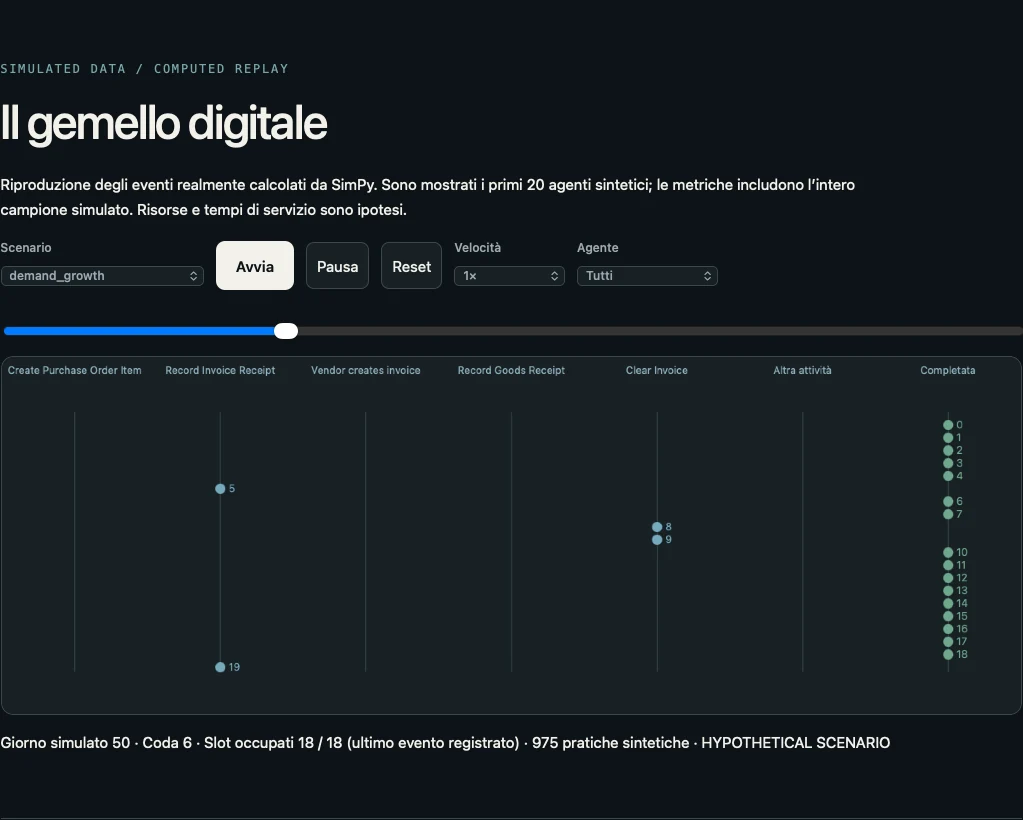
Replay interattivo di una simulazione realmente calcolata. Scegli scenario, pratica sintetica e istante: il sito riproduce gli eventi, mentre il calcolo scientifico resta locale.
SCENARI IPOTETICI / NON VALIDATI
Primi 20 agenti visualizzati; le metriche comprendono l’intero campione. Code e slot sono calcolati con parametri ipotetici, non capacità osservate dell’azienda.
…
VERIFIED RESEARCH OUTPUTS
OTE-001 / OBSERVED
532a63990523a89438a28fd0b68fb52db5cca98183be0b59a7fc1c340ec9c3eaOTE-002 / COMPUTED RESULT
5947b4bc8b35778d6c4735b21e43849dcb9ea17767bf8ca53dc7114a4cb5e4cdOTE-003 / HYPOTHETICAL SCENARIO
6855a0170325dffa811a51831f47be6741f66f879d8619900076fddba8db8742SHARED COMPUTATIONAL SERVICES
Acquisizione, job persistenti, provenance e confini API riutilizzano lo Shared Research Core. Un adattatore SimPy estende Dynamics Lab con eventi discreti; il simulatore del movimento e i cinque Research Engines restano invariati.
Architecture & reuse ↗LOCAL WORKSPACE
Overview, Process Explorer, Performance, Digital Twin, What-If Lab, Validation e Research Results. Nuovi scenari vengono calcolati dal backend locale; il sito pubblico presenta report statici e replay autentici.
OPEN SOURCE / APACHE 2.0
Codice originale Apache 2.0. BPI Challenge 2019 resta CC BY 4.0, con attribuzione a Boudewijn van Dongen e 4TU.ResearchData. I log originali e gli identificativi non sono pubblicati con il pacchetto.
Qualificato su Mac Apple Silicon con Python 3.12. Windows e Linux non collaudati. L’IA locale è opzionale; nessun modello da scaricare per i calcoli.
python3.12 operations_twin/setup.py
.venv-ote/bin/python -m operations_twin.cli serve